真正费时间的,
不是「看」,是「反复对照」。
同一份简历,销售负责人看客户结构,HR 看稳定性,用人经理看项目深度。三个人三套标准,来回传文件、补备注、再排序——大部分时间花在对齐口径和整理格式上,而不是判断候选人。
扫描件、招聘平台导出、图片简历混在一起,格式各不相同,先得挨个打开。
同一批关键词,在 60 份简历里有五六种写法,只能一份份找、一份份记。
谁优先面,理由还得能说服用人经理;改一次口径,前面排的全要重来。
面试题、技能分布、薪资预期,全部重新整理一遍,才能开面。
把一次口头标准,
变成一条能重复跑的流水线。
不画流程图,不维护脚本。你只需要把「什么样算合适」讲清楚一次。
定口径
把 JD 拆成硬性条件、加分项、排除项。「3 年以上 B 端 SaaS 销售」是硬性,「有制造业大客户」是加分,「近两年换过 3 份工作」是排除。
读文件
批量读取 PDF、Word、图片简历,抽取学历、年限、行业、客户类型、项目规模、技能、跳槽节奏。打不开的文件会单独列出,不会静默跳过。
打分分级
每份给 A(优先面)/ B(备选)/ C(不合适),并写明匹配证据和不确定项;证据不足的标出来,不猜。
出交付
分级名单、面试建议、技能分布一起落进你指定的目录,文件名带日期,随时能回溯。
你打开的是一个目录,
不是一段聊天记录。
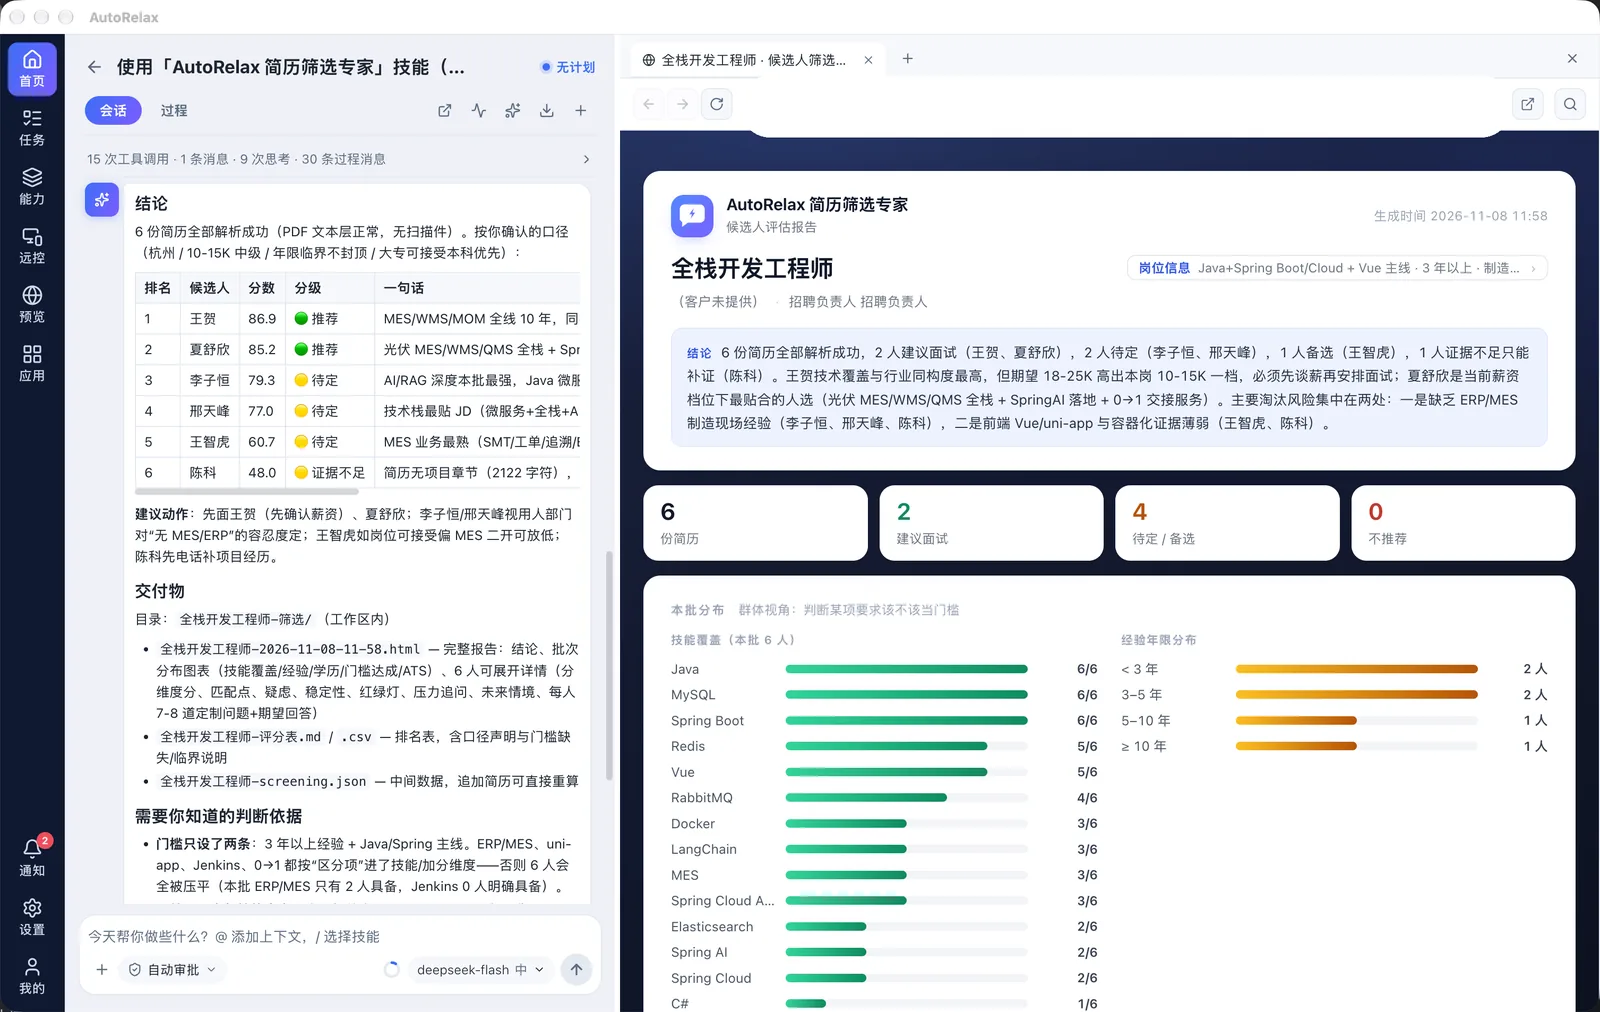
姓名、档位、匹配维度、关键证据、风险提示,按匹配度排序。
A 档问什么、B 档验什么、C 档为什么放掉,每档都有对应的追问。
60 人里会 SQL 的有几人、带过百万级客户的有几人,用来反向校正 JD。
读了哪些文件、哪些解析失败、哪些字段缺失,出了问题能倒查。
它出初筛,
你出判断。
- 定一次口径
- 看一眼边界案例
- 见人
- 不替你发 offer
- 不联系候选人
- 不做背景调查
- 不美化不匹配的人——宁可标 C,也不凑数
口径写得越像标准,
名单越像人筛的。
下面是一段可以直接改用的示例,把岗位、硬性、加分、排除写清楚就够了。
岗位:B 端 SaaS 销售(制造业方向)

硬性:本科及以上;3 年以上 B 端销售;有制造业或工业客户经验
加分:独立签过 50 万以上单;做过客户续约;有渠道资源
排除:近 2 年换过 3 份及以上工作;简历里没有具体客户或业绩
输出:A/B/C 三档 + 每档理由,按匹配度排序,字段按你的名单习惯配置什么人用它最省事,
什么人不该用。
- 一次 20 份以上,格式杂
- 岗位画像清晰,说得出「什么样算合适」
- 需要给用人经理一份能解释的排序
- 5 份以内,自己看更快
- 高管、核心岗猎聘,需要深度访谈和背调
- 岗位本身没有标准——先定口径,再谈自动化
简历只在本机读取、在本机生成产物,不经过我们的服务器;需要模型判断的环节,按你配置的供应商 Key 调用,费用由供应商收取,我们不抽成。断网期间任务排队,恢复后继续。
开始之前,
你可能想先问清楚。
支持哪些简历格式?
PDF、Word、图片(扫描件和截图)、招聘平台导出的表格都能读;解析失败的会单独列出来,不会静默跳过。
10 分钟是真的吗?
60 份、口径清晰、文件可读的前提下,跑完加复核约 10 分钟。扫描件模糊、字段缺失多会变慢,这是典型样本口径,不承诺每一批都这么快。
分级不准怎么办?
初筛本来就是概率活。所以我们给的是「证据 + 风险点」,不是一句结论;边界案例单独标出来给你看。口径写清楚,效果会明显好于关键词过滤。
能按我们公司的模板输出吗?
字段和排序规则都能配,名单、面试题、汇总表的结构按你的习惯来。
简历会被上传吗?
不经过我们的服务器;需要模型判断的环节走你自己配置的供应商 Key。
先拿手上那批简历试一次
加微信,发你安装包和一份筛选口径模板。装好后把那批简历丢给它,先看名单对不对。
内测期免费 · 模型费用自理 · Windows / macOS
扫码加微信,备注「AutoRelax」